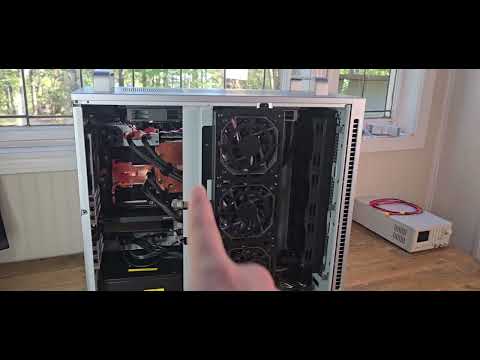
Datacenter at Home - GB300 GPU - w/ Asus DGX Station (ET900N G3)
AI Summary
Voici un résumé du contenu de la vidéo :
La vidéo présente la station ASUS ET900N G3, une machine conçue pour des tâches intensives, souvent comparée à la station NVIDIA DGX. L'orateur met en avant ses caractéristiques clés : 748 Go de mémoire cohérente et le GPU GB300. Il souligne que le GB300 est une technologie « extra-terrestre » avec 252 Go de mémoire à haute bande passante, atteignant plus de 7 To/s, ce qui est considérablement plus rapide que les 1,7 To/s d'une RTX Pro 6000. L'orateur exprime initialement son scepticisme quant à la performance du GB300 par rapport à une configuration de quatre RTX Pro 6000, mais ses tests révèlent que la station ASUS est supérieure. Le prix est comparé à celui d'une configuration de six RTX Pro 6000, mais la station ASUS est plus compacte et conçue pour un format de bureau. Elle est alimentée par une seule prise de 1600 W, le GPU consommant la majorité de cette puissance.
Les dimensions de la machine sont ensuite abordées, avec une façade amovible qui réduit sa largeur. Bien que des barres sur le dessus suggèrent une possibilité de montage en rack, l'orateur indique que la largeur de 23 pouces (moins environ un pouce avec la façade retirée) la rend incompatible avec les racks standard de 19 pouces. Le processeur et la RAM LPDDR5X sont considérés comme bons, mais le véritable atout est la combinaison avec le GB300. L'orateur réitère que la mémoire cohérente de 748 Go est plus performante lorsqu'elle n'est pas entièrement utilisée, et que la bande passante de la mémoire LPDDR5X (396 Go/s) est bien inférieure à celle du HBM3E du GB200 (7,1 To/s).
La connectivité réseau est mentionnée comme un facteur clé pour la mise à l'échelle. L'orateur a rencontré des difficultés à connecter quatre RTX Pro 6000 via un switch PCIe en raison de problèmes de BAR et de P2P. Il recommande d'acheter une deuxième station DGX et de les relier via un ConnectX-8 (deux ports 400 Gb) pour une mise à l'échelle efficace, bien que cela puisse devenir coûteux avec des switches supplémentaires. L'orateur déconseille vivement l'utilisation de la RTX Pro 4000 dans cette machine, recommandant plutôt la RTX Pro 6000.
La discussion se tourne ensuite vers le modèle DeepSeek V 4.1 flash. L'orateur critique une version antérieure pour sa consommation excessive de jetons par rapport à d'autres modèles comme GLM 53 flash. Il mentionne une recette d'optimisation trouvée sur GitHub, provenant de la communauté Local Inference Lab, qui a permis d'améliorer les performances sur la DGX Station. Cette recette consiste à placer les poids du modèle et les experts « chauds » sur le GB300, les experts « froids » sur une RTX Pro 6000 en tant que « sidecar », et à utiliser la mémoire LPDDR5X pour les tables d'engrammes et le cache de page.
Les performances du DeepSeek V 4.1 flash sur la DGX Station sont ensuite détaillées. En mode mono-flux, le modèle atteint environ 237 tokens/seconde pour le texte général et plus de 400 tokens/seconde pour le codage. Avec 16 processus simultanés, le débit total peut atteindre près de 1900 tokens/seconde, avec environ 84 tokens/seconde pour le texte général et 100 tokens/seconde pour le code par flux. L'orateur estime que 100 tokens/seconde est un minimum acceptable et que 200 tokens/seconde est idéal pour une exécution locale rapide. Il souligne l'avantage de ces performances pour la confidentialité des données en entreprise. Il mentionne également un nouveau modèle, le DPC401, qui semble prometteur et pourrait surpasser le GLM 53 flash.
Un autre point fort de la DGX Station est sa vitesse de pré-remplissage à froid, mesurée à 44 000 tokens/seconde, avec des pics atteignant 61 000 à 63 000 tokens/seconde, soit le double des performances d'une RTX 6000 standard (9 000 à 20 000 tokens/seconde). L'orateur estime pouvoir atteindre une moyenne de 60 000 tokens/seconde en pré-remplissage. Il compare ensuite la complexité de la mise en place de configurations multi-GPU avec des câbles MCIO, des problèmes de dissipation thermique et de consommation d'énergie, à la simplicité d'utilisation de la DGX Station, qui est une solution « prête à l'emploi ».
En termes de températures, le GB300 reste remarquablement frais. Au repos, il est à 35°C. En pleine charge (100%), la température moyenne est de 61°C, avec un pic de 75°C. La RTX Pro 6000 utilisée comme « sidecar » affiche également des températures basses (environ 60°C en moyenne), ce qui est attribué à l'utilisation limitée des experts « froids ». Ces chiffres sont jugés impressionnants, car maintenir des RTX Pro 6000 à des températures similaires nécessite des solutions de refroidissement plus complexes et une consommation d'énergie doublée.
La comparaison avec le modèle GLM 53 flash sur une configuration de quatre RTX Pro 6000 est ensuite abordée. L'orateur estime que, dans ce cas, les deux configurations sont à égalité en termes de performances globales, bien que la DGX Station soit légèrement plus rapide pour le temps jusqu'au premier jeton et pour une entrée de 8K. Le pré-remplissage est environ trois fois plus rapide sur la DGX Station, mais le coût de cette dernière est plus élevé. L'orateur considère ce scénario comme le « pire cas » pour la DGX Station en termes de rapport performance/prix.
Le « meilleur scénario » pour la DGX Station est ensuite présenté avec le modèle Emo Tron. Bien que le Qwen 3 8B Flash Next soit considéré comme un modèle plus intelligent, l'Emo Tron sur le GB200 est significativement plus rapide. Des démonstrations de génération de code montrent des débits allant de 450 à 518 tokens/seconde, avec des pics atteignant 554 tokens/seconde. L'orateur souligne également le temps très rapide jusqu'au premier jeton.
Une démonstration approfondie de l'évolutivité du modèle Emo Tron est ensuite réalisée en utilisant une interface personnalisée. Avec un seul flux (C1), le débit est d'environ 300 tokens/seconde. Avec quatre flux (C4), le débit agrégé atteint 1,2 milliers de tokens/seconde, soit environ 300 tokens/seconde par flux. Avec 16 flux (C16), le débit agrégé monte à 2,8 milliers de tokens/seconde, chaque flux maintenant plus de 100 tokens/seconde. Avec 64 flux (C64), le débit agrégé atteint un pic d'environ 7,2 milliers de tokens/seconde, chaque flux dépassant également les 100 tokens/seconde. L'orateur est stupéfait par cette évolutivité, la comparant à l'impossibilité de réaliser des « essaims d'agents » avec d'autres configurations. Il note que cette performance ne se retrouve pas avec les RTX Pro 6000, et il cherche encore à comprendre pourquoi le GB300 est si efficace.
En conclusion, l'orateur exprime son admiration pour la station DGX, la décrivant comme une machine « merveilleuse » et « dingue ». Il regrette de devoir la rendre, car il s'y est attaché malgré son coût élevé. Il anticipe des futures vidéos explorant davantage les capacités de la machine, notamment pour les essaims d'agents et l'évolutivité des modèles.