Cancel your subscriptions, Ox-Alpha is here! (GLM 5.3 Flash)
AI Summary
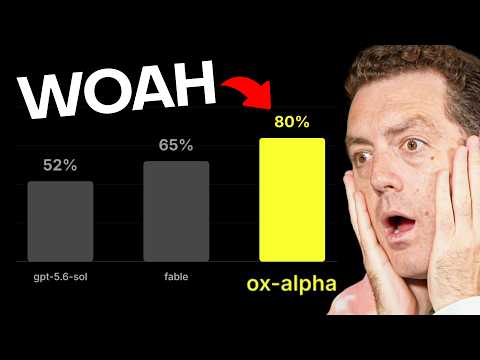
Des rumeurs ont circulé récemment concernant un modèle mystérieux nommé Ox Alpha, apparu sur Open Router. Les spéculations allaient d'un nouveau modèle Gemini à une innovation en apprentissage continu. Ce modèle s'est avéré exceptionnel, rivalisant avec les modèles de pointe les plus performants. Il a finalement été identifié comme GLM 5.3 Flash, la dernière création open-source et open-weights de Z AI. Le terme "Flash" indique une version rapide, économique et plus petite, ce qui le rend particulièrement remarquable. Malgré sa taille réduite, ce modèle offre des performances impressionnantes. Il pourrait bien s'agir de l'une des sorties les plus excitantes à ce jour, offrant la possibilité de le télécharger et de l'exécuter localement, ou de l'utiliser à une fraction du coût des modèles comme Fable ou GPT 5.6 Soul, tout en conservant une capacité incroyable.
Z AI, un laboratoire d'IA chinois, est réputé pour ses contributions significatives à la communauté open-source et open-weights. En partageant les poids de leurs modèles, ils permettent aux utilisateurs de les utiliser, de les personnaliser, de les affiner et de les héberger eux-mêmes, offrant ainsi une valeur immense. GLM 5.3 Flash est un modèle relativement petit, comportant 320 milliards de paramètres dont 18 milliards sont actifs, une architecture "mixture of experts" qui assure une exécution efficace et une grande capacité. Il surpasse GLM 5.2, la version précédente, et sa version complète. De plus, cette version Flash coûte un dixième du prix de GLM 5.2, qui était déjà abordable, et s'approche des performances de Claude Opus 4.8 sur des tâches de codage et de type agent. Bien qu'il ne puisse être directement comparé à des modèles de plusieurs trillions de paramètres comme Fable, sa proximité en termes de performances est remarquable compte tenu de la différence de taille.
Les benchmarks montrent GLM 5.3 Flash à 84.3 sur Terminal Bench, une amélioration significative par rapport à GLM 5.2. Sur Deepseek, il se positionne de manière compétitive par rapport à Opus 4.8 et GPT 5.6 Terra. Sur Deep Suite, un indicateur de performance en conditions réelles, il atteint 63.4, un bond considérable par rapport à la version précédente, se montrant très compétitif face à GPT 5.6 Terra. Sur l'indice OpenAI de travail de connaissance en conditions réelles, il se classe numéro un avec une large marge.
Un aspect crucial est le coût par tâche complétée. En termes de performance d'agent pour le codage, GLM 5.3 Flash se rapproche de Fable, tout en utilisant un peu plus de tokens mais à une fraction du coût. Sur l'indice d'intelligence artificielle, GLM 5.3 Flash atteint 57, contre 62 pour Claude Fable 5, pour une taille et un prix considérablement inférieurs.
Le coût par tâche d'intelligence est particulièrement révélateur. Claude Fable 5 coûte 3,14 $ par tâche, GPT 5.6 Soul 95 cents, Kimmy K3 84 cents, et GLM 5.3 Flash seulement 9 cents. Ce dernier est à peine inférieur aux performances de pointe de Fable 5, pour environ 2 à 3 % de son coût. L'indice Intelligence versus Coût place GLM 5.3 Flash dans le quadrant idéal (haut et à gauche). Bien que GPT 5.6 Luna Max soit moins cher, GLM 5.3 Flash offre une intelligence supérieure pour un coût légèrement plus élevé. Il est important de noter que GPT 5.6 Luna Max utilise beaucoup moins de tokens pour accomplir une tâche, ce qui le rend plus économique malgré un indice d'intelligence légèrement inférieur. La nature open-source et open-weights de GLM 5.3 Flash laisse présager des améliorations futures rapides.
Parmi les caractéristiques notables, on trouve un contexte d'un million de tokens, 131 000 tokens de sortie maximum, et une capacité de raisonnement par défaut. Un chiffre impressionnant est sa capacité à servir 100 trillions de tokens par jour en utilisant exclusivement des puces chinoises, sans aucune puce Nvidia. Cela démontre la capacité de la Chine à développer son propre écosystème matériel et logiciel pour l'IA, avec des performances et un coût par token comparables aux GPU Nvidia.
Pour tester GLM 5.3 Flash, il est possible de passer par Z.AI ou Open Router, ainsi que d'autres fournisseurs d'inférence qui entrent en compétition sur les prix. Il est compatible avec les API de type OpenAI, permettant son intégration dans divers projets. Les démonstrations incluent une simulation de Rubik's Cube hyper-réaliste et fluide, ainsi que la création de divers sites web. Dans une comparaison avec GPT 5.6 Soul pour la création de scènes 3D, Soul est jugé supérieur en détail et cohérence. Pour la conception de sites web, GLM 5.3 Flash est souvent préféré pour son design plus esthétique, malgré l'absence d'accès à internet pour récupérer des images réelles, contrairement à Soul. Un exemple notable est la création d'un site sur la Tesla Model Y, où GLM 5.3 Flash a presque copié le site officiel Tesla, tandis que Soul a construit un site plus original mais moins convaincant. Une performance remarquable a été la création d'une présentation PowerPoint sur les data centers, respectant les directives de marque de "Forward Futures" avec une grande précision. Ce niveau de performance et d'efficacité, combiné à la nature open-source, est un développement majeur.