Mistral is BACK! (Le Chonk)
Audio Summary
AI Summary
Mistral a lancé Mistral Large 4, surnommé officieusement Lechonk, un modèle de pointe entièrement développé en Europe, avec un billion de paramètres, des poids ouverts et en open source. Ce modèle hybride d'instruction et de raisonnement utilise une architecture de mélange d'experts (MoE), ce qui signifie que bien qu'il ait un billion de paramètres, seule une partie d'entre eux est active pour chaque requête, ce qui le rend plus gérable. Il est multimodal, unifie les capacités d'instruction, de raisonnement et d'agentivité, et excelle en cybersécurité, obtenant d'excellents scores sur Cyber Gym.
Le modèle est proposé à un prix très compétitif : 1,36 $ par million de tokens d'entrée et 4,18 $ par million de tokens de sortie. Il compte 49 milliards de paramètres actifs, ce qui est un excellent ratio par rapport au total. Mistral Large 4 démontre des performances exceptionnelles en codage, dans les flux de travail d'agents et en compréhension multimodale. Bien qu'il soit très compétitif au niveau mondial parmi les modèles open source, un modèle chinois le surpasse souvent, et les modèles propriétaires américains ont encore une avance d'au moins six mois. Les entreprises propriétaires comme OpenAI et Anthropic sortent des modèles rapides et économiques, réduisant l'avantage de prix et de vitesse des modèles open source, bien que ces derniers offrent toujours la propriété, la confidentialité et la garantie de non-rétention des données.
Mistral Large 4 surpasse "significativement" tout modèle open-weight développé aux États-Unis ou en Europe, mais les modèles chinois sont exclus de cette comparaison car ils sont "absolument en pleine effervescence". Les poids du modèle devraient être publiés d'ici la fin du mois. En attendant, le modèle est testé en conditions réelles avec des leaders de la cybersécurité, des partenaires agréés et des autorités étatiques, qui peuvent y accéder avec une modération réduite et des capacités cyber étendues. Cette approche est similaire à celle des "Frontier Labs" qui mettent en place des garde-fous pour le public tout en les réduisant pour les partenaires de confiance.
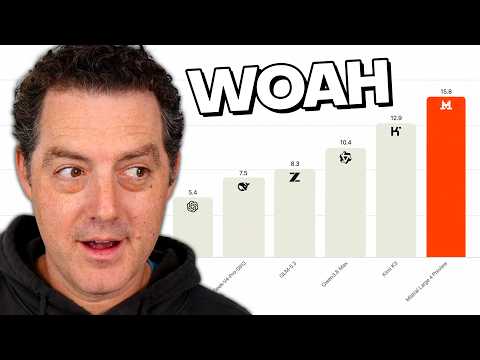
Sur le benchmark Deep 1.1, Mistral Large 4 Preview obtient un score de 62, se classant deuxième parmi les modèles open source derrière Kimmy K3 et GLM 5.3. Sur Terminal Bench, il est également deuxième. En cybersécurité (AA Cyber Index), il est à égalité avec GLM 5.3 Flash à 50 points, en première position. Sur Automation Bench, il obtient 59,9, contre 62,2 pour GLM 5.3. Il montre une amélioration significative par rapport à Mistral Medium 3.5. Sur le benchmark légal de Harvey, Mistral Large 4 domine, surpassant même GPT6 Astra et Kimmy K3.
Un aspect crucial est la souveraineté : ce modèle a été entièrement conçu, créé, entraîné et est inféré en Europe. Il n'est pas basé sur des modèles existants comme Kimmy ou Quen, mais a été entraîné de zéro sur 3 800 GPU Nvidia Grace Blackwell dans son propre centre de données européen.
Malgré ses performances, l'intégration de Mistral Large 4 dans des environnements d'agentivité est difficile. L'orateur a tenté de l'utiliser pour une simulation de Rubik's Cube et a rencontré des problèmes de consommation excessive de tokens et de limites de contexte, nécessitant un débogage manuel. L'expérience utilisateur est moins fluide que celle des modèles propriétaires ou de produits comme Codeex ou Cursor. L'open source excelle lorsque l'expertise est disponible et à grande échelle, permettant de décharger certaines tâches vers des modèles moins coûteux et entièrement contrôlables, ce qui profite aux entreprises.
En cybersécurité, Mistral Large 4 est l'un des modèles les plus puissants au monde, se classant parmi les cinq premiers mondialement et dominant les modèles open-weight hors de Chine. Cependant, sur l'Artificial Analysis Intelligence Index global, il se classe 25e sur 25, loin derrière les modèles d'Anthropic (Claude Opus 5.5, Fable 5.1) et d'OpenAI (GPT6 Astra). L'indice d'intelligence par rapport au coût par intelligence révèle que Mistral Large 4 est bon marché mais moins performant que GPT 6.1 Soul ou Opus 5.5.
Les modèles récents d'Anthropic et OpenAI, comme 6.1 Soul et Opus 5.5, sont très performants, rapides et économiques, ce qui remet en question la course à l'innovation. Cependant, les modèles open source comme Mistral 4 offrent un contrôle total, la possibilité d'ajouter ou de supprimer des garde-fous, et la personnalisation. La communauté pourra optimiser ses performances pour des cas d'utilisation spécifiques.
Un inconvénient de Mistral 4 est sa fenêtre contextuelle limitée à un demi-million de tokens, comparée au million de tokens de la plupart des autres modèles. En revanche, il est rapide, atteignant 116 tokens par seconde, juste derrière des modèles comme Deepseek v4.1 Flash et Musepark. Sur Cyber Gym, il est le modèle open source numéro un, avec un score de 82.
L'orateur exprime sa satisfaction de voir un nouveau modèle open source provenant d'une entreprise européenne, Mistral, qui est compétitif. Bien qu'il y ait des "problèmes à régler" concernant l'intégration facile, cette avancée est "bonne pour le monde".